


onwx — AMD Ryzen AI の NPU で LLM
日本語 | English
LLM を AMD Ryzen AI の NPU(XDNA2)だけで 動かすアプリです。行列計算から DeltaNet・アテンション・LM ヘッドまで、 1 トークンの計算をすべて NPU の上で行います(CPU は単語の表引きと次の単語の選択だけ)。NPU 向けのプログラムは モデルごとに作ってあるので、PC の上でコンパイルを待つことはありません。
OpenAI 互換 API サーバーとブラウザのチャット画面、タスクトレイのアプリ(モデルのダウンロード・切り替え・設定)を備えています。
Intel の NPU(Core Ultra)向けは姉妹アプリの onw です。onwx は AMD Ryzen AI 専用で、 モデルも NPU 用プログラムも別物です(互いのモデルは使えません)。
速さ(FastFlowLM との比較)
AMD Ryzen AI の NPU で LLM を動かす代表的なアプリ FastFlowLM(FLM)1.0.8 と、
同じ測り方で比べました(Qwen3.5 9B、Ryzen AI Max+ 395、NPU は performance モード)。プロンプトは FLM の flm bench
と同じ文章(長さ 128〜32K トークン)で、プロンプトを読み終わるまでの時間(TTFT)と、そのあと 32 トークンの生成を測っています。
点線は、設定の「CPU も使ってプロンプトの読み込みを速くする」をオンにした値です(既定はオフ)。
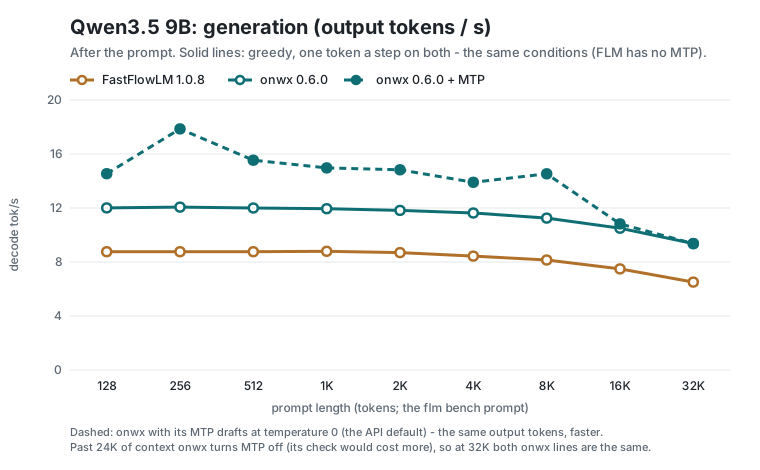
生成速度はどちらも MTP なし(温度 0 で 1 トークンずつ)の値です。FLM の Qwen3.5 には MTP がないので、条件はそろっています。 onwx の MTP(温度 0 のときの先読み)を使った値は、生成のグラフに破線で示しました。
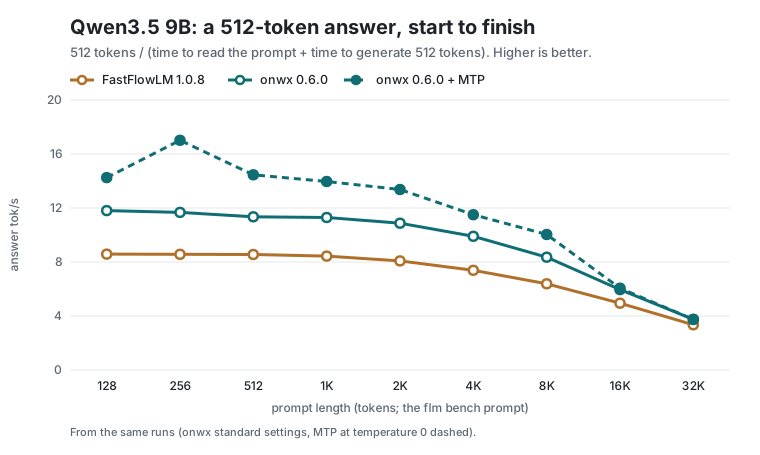

- 512 トークンの回答をプロンプトから書き終えるまでの実効速度(512 ÷ 合計時間)は、128〜32K のどの長さでも onwx が上です(MTP なしでも)。
- プロンプトの読み込みは 2K〜8K で onwx が速く(1K はほぼ同じ。4K で FLM 8.7 秒、onwx 7.7 秒)、256〜512 と 16K〜32K では FLM が少し速いです。CPU も使う設定では 16K まで onwx が速く、32K でほぼ同じです(FLM 74 秒、onwx 74 秒)。
- 生成はどの長さでも onwx が 3〜4 割速く、MTP を使うと 8K までの文脈で約 14〜18 tok/s です(24K を超えると MTP は自動で止まります)。
- エージェントでも速い:Hermes Agent のコーディング作業(バグ修正、29 回のやり取り、文脈 1.2 万〜2.9 万トークン)で記録した同じリクエストを流すと、全体で onwx 0.6.1 が 778 秒、FLM が 874 秒でした(0.6.0 は 989 秒。長い文脈の後ろに足す読み込みを 0.6.1 で速くしました)。
- Ryzen AI 9 HX 370 でも傾向は同じでした(onwx 0.5.0。32K のプロンプト:FLM 379 tok/s、onwx 339 tok/s、生成 FLM 6.0 tok/s、onwx 8.9 tok/s)。
インストール(コマンドを 1 行貼るだけ)
Windows
- スタートメニューで「PowerShell」と入力し、「Windows PowerShell」を開きます(管理者として開く必要はありません)。
- 次の 1 行をコピーして貼り付け、Enter を押します。
irm https://huggingface.co/ryugyosoft/onwx/resolve/main/install.ps1 | iex
onwx が %LOCALAPPDATA%\onwx にダウンロードされ、セットアップの黒い画面が開きます。Python が見つからない場合は
「Install Python 3.12 ... [Y,N]?」と聞かれるので Y を押してください。数分で終わり、タスクトレイ(画面右下)に
赤い onwx のアイコンが出て、モデルを選ぶウィンドウが開きます。
Ubuntu(試験的:Ubuntu 26.04 で動作の報告あり)
curl -fsSL https://huggingface.co/ryugyosoft/onwx/resolve/main/install.sh | bash
貼り付ける前に中身を確認したい場合は、install.ps1/install.sh を開いて読めます。 新しい版が出るとトレイと onwx のウィンドウに通知が出て、ボタン 1 つで更新できます。
必要なもの
XDNA2 NPU を搭載した AMD Ryzen AI の PC:Ryzen AI 300 シリーズ(Strix Point、例:Ryzen AI 9 HX 370)、 Ryzen AI Max シリーズ(Strix Halo、例:Ryzen AI Max+ 395)
Windows 11 と AMD の NPU ドライバー(32.0.203 以降で確認。Windows Update か PC メーカーのドライバーで入ります)。 タスクマネージャーの「パフォーマンス」に NPU が出ていれば大丈夫です
Ubuntu では NPU ドライバー(amdxdna)に加えて、AMD の NPU ランタイム XRT(Python バインディング pyxrt 付き)が必要です。カーネルのドライバーだけでは動きません。Ubuntu 26.04 なら、AMD の Lemonade の PPA から入れるだけです(ビルドは不要):
sudo add-apt-repository ppa:lemonade-team/stable
sudo apt update
sudo apt install python3-xrt libxrt-npu2
ほかの版では AMD の xdna-driver の手順で XRT と NPU プラグインをビルドして入れます。足りないものがあると、onwx のウィンドウに理由と入れ方が出ます
メモリ 16 GB 以上(Ternary Bonsai 2 27B で約 8.8 GB を使います)
空き容量:アプリ約 0.5 GB + モデル 7.6 GB
インターネット接続(最初のダウンロードのとき)
使い方
インストールが終わると開く onwx のウィンドウで、3 ステップです。
- 「モデル」タブで「ダウンロード」。
- 「サーバー」タブで「ロード」(数秒で終わります)。
- 「動作中」になったら、「チャット」でブラウザのチャット画面が開きます。他のアプリからは、base URL
http://127.0.0.1:8100/v1(「サーバー」タブに表示)の OpenAI 互換 API として使えます。
コマンドで使う場合:
onwx serve ryugyosoft/Ternary-Bonsai-2-27B-onwx     # チャット画面と API(http://127.0.0.1:8100)
onwx chat ryugyosoft/Ternary-Bonsai-2-27B-onwx      # 端末でチャット
モデル
| モデル | ダウンロード | メモリ | プロンプトの読み込み(1,000 / 4,000 トークン) | 文章の生成 |
|---|---|---|---|---|
| Ternary Bonsai 2 27B(三値・2 ビット、Qwen3.8-27B ベース) | 7.6 GB | 約 8.8 GB + 文脈 1k トークンあたり約 34 MB | 約 9.3 秒 / 約 28 秒 | 約 6.9 tok/s |
| Qwen3.6 35B-A3B(MoE・int4、1 トークンあたり 3B、画像も読める) | 20.8 GB | 約 20.2 GB + 文脈 1k トークンあたり約 24 MB(エキスパートを SSD から読むと約 7 GB〜) | 約 3.1 秒 / 約 9.3 秒 | 約 20 tok/s、温度 0 なら MTP で約 23 tok/s |
| Ternary Bonsai 2 9B(三値・2 ビット、画像も読める、Qwen3.5-9B ベース) | 3.4 GB | 約 4.1 GB + 文脈 1k トークンあたり約 15 MB | 約 2.1 秒 / 約 6.9 秒 | 約 20 tok/s |
| Ternary Bonsai 2 4B(三値・2 ビット、画像も読める、Qwen3.5-4B ベース) | 2.3 GB | 約 3.3 GB + 文脈 1k トークンあたり約 13 MB | 約 1.8 秒 / 約 5.8 秒 | 約 29 tok/s |
| Qwen3.5 9B(int4、画像も読める) | 7.6 GB | 約 5.8 GB + 文脈 1k トークンあたり約 15 MB | 約 2.5 秒 / 約 7.7 秒(CPU も使う設定で約 2.1 秒 / 約 6.6 秒) | 約 12 tok/s、温度 0 なら MTP で約 15 tok/s |
| Qwen3.5 4B(int4、画像も読める) | 4.8 GB | 約 3.4 GB + 文脈 1k トークンあたり約 13 MB | 約 2.1 秒 / 約 6.4 秒(CPU も使う設定で約 1.8 秒 / 約 5.7 秒) | 約 18 tok/s |
| llm-jp-4.1 8B thinking(int4、日本語に強い) | 5.8 GB | 約 4.8 GB + 文脈 1k トークンあたり約 65 MB | 約 6.3 秒 / 約 13 秒 | 約 11 tok/s |
(Ryzen AI Max+ 395・Windows で測定。Qwen3.6 35B-A3B は onwx 0.9.0、Ternary Bonsai 2 9B / 4B は 0.7.0、Qwen3.5 9B / 4B は 0.6.0、ほかは 0.5.0。0.6.0 ではプロンプトの読み込み中に NPU の完了を待つ方法を変え、1K トークン以上の読み込みが 0.5.0 より約 1 割速くなりました)
Qwen3.6 35B-A3B を少ないメモリで(0.9.0):エキスパートを SSD に置いたまま、ルーターが選んだものだけを読み込み、最近使ったものをメモリに残せるようになりました(onw と同じ方式。OS のファイルキャッシュを通さない直接読み込みで、次の層で使いそうなものは先読みします)。設定の「MoE のエキスパートのメモリ」で量を選べます(既定の「自動」は、モデル全体がメモリの 7 割に収まればすべてメモリに置きます)。4 GB にすると使用メモリは約 20 GB → 約 7 GB、生成は約 20 → 約 15 tok/s、プロンプトの読み込みは 1,000 トークンで 3.1 → 3.5 秒、4,000 トークンで 9.3 → 10.2 秒です(Ryzen AI Max+ 395 の内蔵 NVMe)。0.9.0 では画像も読めるようになり(画像のエンコーダーは CPU。画像を含むプロンプトは今のところ 1 トークンずつ読みます)、MTP も速くなりました(約 22 → 約 23 tok/s)。モデルの更新が必要です(変わったファイルだけをダウンロードします)。
Qwen3.6 35B-A3B(0.8.0 で追加):256 個のエキスパート(1 トークンに 8 個+共有の 1 個)を持つ MoE で、全体は 35B、1 トークンの計算は 3B 分です。重みは int4 で、エキスパートを選ぶルーターも含めて全部 NPU で動かします(ルーターは NPU が int4 で 16 候補まで絞り、CPU が上位 8 個を正確に選び直します)。生成は約 20 tok/s、温度 0 なら MTP で約 22 tok/s です。プロンプトは 1,024 / 2,048 トークンずつ NPU でまとめて読み、選ばれたエキスパートごとにトークンを集めて int4 の重みのまま行列計算します(1,000 トークンで約 3.1 秒、8,000 トークンで約 19 秒、32,000 トークンで約 93 秒)。同じ PC の FastFlowLM 1.0.8 と比べると、プロンプトの読み込み(TTFT)は 1K で 10.2 → 3.1 秒、4K で 18.4 → 9.3 秒、8K で 27.7 → 19.2 秒、32K で 97.9 → 92.7 秒、生成は 15.6 → 20.7 tok/s です。すべてメモリに置くと約 20 GB 使います(Ryzen AI Max+ 395 / 128 GB で確認。HX 370 / 32 GB では未確認)。読み込みの合間の処理はいつも CPU で行います(AVX-512 が必要です)。
Ternary Bonsai 2 9B / 4B(0.7.0 で追加):Prism ML が Qwen3.5-9B / 4B を三値(−1・0・+1)の重みで学習し直したモデルです。重みを 2 ビットのまま NPU に載せるので、同じ大きさの int4 のモデルよりダウンロードもメモリも小さく、生成も速くなります(9B で約 20 tok/s。Qwen3.5 9B の int4 は約 12 tok/s)。画像も読めます(画像のエンコーダーは CPU で動きます)。プロンプトはほかのモデルと同じく NPU でまとめて読みます(2 万トークンで 9B 約 39 秒・4B 約 34 秒。この 2 モデルは読み込みの合間の処理をいつも CPU で行います。AVX-512 が必要で、Ryzen AI 300 / Max は対応しています。画像を含むプロンプトは今のところ 1 トークンずつ読みます)。
llm-jp-4.1 8B と Ternary Bonsai 2 27B の長いプロンプトが速くなりました(0.7.0):プロンプトの読み込みのアテンションを、Qwen3.5 と同じ新しい方式(pfa5)にしました。llm-jp は 2 万トークンのプロンプトを最初から読むのが 136 → 82 秒、2 万トークンの文脈の後ろに 2,000 トークンを足すのが 29.8 → 18.5 秒、Ternary Bonsai 2 27B は 2 万トークンが 165.6 → 138.8 秒、1.2 万トークンの文脈の後ろに 352 トークンを足すのが 31.2 → 9.8 秒です。エージェントのように長い会話に少しずつ足していく使い方で特に効きます。モデルの更新が必要です(「モデル」タブに更新の案内が出ます。変わったファイルだけをダウンロードします)。
プロンプトは NPU でまとめて読み込みます。256 トークン以上(llm-jp は 32 トークン以上)は 1,024 / 2,048 トークンずつ、NPU の 32 個の AI エンジン全部で 1 層ずつ計算します(行列計算は bfp16 の行列ユニット。重みはその層の直前に NPU 上で展開するので、使用メモリの増加は作業領域の約 0.5 GB だけです)。短いプロンプトは従来どおり 128 / 32 トークンずつの経路で読みます。
設定の「CPU も使ってプロンプトの読み込みを速くする(消費電力が増えます)」をオンにすると、NPU の計算の合間の小さな処理を CPU(省電力側のコア)で行い、1K トークン以上のプロンプトの読み込みが 1〜2 割速くなります(Qwen3.5 9B、4K トークンで 7.7 → 6.6 秒)。読み込み中の消費電力は数 W 増えます。長いプロンプトほど効きます。既定はオフです。
アテンションのキャッシュ(キーと値)は int8 で持つので、文脈 1k トークンあたりのメモリは 0.3.0 の半分です。
Qwen3.5 9B と Qwen3.6 35B-A3B は温度 0(API の既定)のとき、モデルの MTP 層で次のトークンを先読みして速く生成します。出力は 1 トークンずつ生成したときと同じです(Qwen3.6 はエキスパートの足し算の順序が違うため、ほぼ同点の候補のところで分かれることがあります。チャット画面の既定のサンプリングでは使いません。
ONWX_MTP=0で止められます)。文脈が 24K トークン(Qwen3.6 は 8K)を超えると、先読みの検証のほうが重くなるので自動で使わなくなります(ONWX_MTP_MAXで変更)。Qwen3.6 は連続する 2 トークンのエキスパートがほとんど重ならないため検証が重く、効果は平均で約 1 割(コードの生成で約 15%)です。先読みが当たりにくい応答では、途中から自動で 1 トークンずつの生成に戻ります。文脈は最大 262144 トークン(モデルの上限。llm-jp は 65536)です。Qwen3.5 9B / 4B は 32K を超える長いプロンプトも NPU の新しい経路で読みます(9B、64K トークンで約 340 tok/s)。既定は 3840 トークンで、設定で変えられます。文脈が長いほど遅くなります。
思考モード(考えてから答える)とツール呼び出しに対応しています。画像は Qwen3.6 35B-A3B・Qwen3.5 9B / 4B・Ternary Bonsai 2 9B / 4B で読めます(画像のエンコーダーは CPU で動きます)。
速度は NPU の電力モードを performance にして測った値です(管理者の PowerShell で
C:\Windows\System32\AMD\xrt-smi.exe configure --pmode performance)。標準のままだと NPU のクロックが下がって 2 割ほど遅くなります。Ryzen AI 300 シリーズ(HX 370 など)も NPU は同じ 32 個の AI エンジンで、同じプログラムが動きます。Windows の AI 機能(Copilot+ の機能)が NPU を使っていると遅くなることがあります。
API
/v1/chat/completions(ストリーミング可)、/v1/models、/v1/messages(Anthropic 形式)、/v1/responses に対応しています。
思考モードは "chat_template_kwargs": {"enable_thinking": true} か "reasoning_effort" で切り替えます。
設定で LAN からの接続を許可すると、他の PC からも使えます(API キーの設定をおすすめします)。
アプリが max_tokens を送らないときの回答の長さの上限は、設定の「API の最大出力トークン」で変えられます(既定 8192)。
ライセンス
onwx は Apache-2.0 です。モデルは元のモデルのライセンスに従います。